Un modello AI su misura ha senso solo se la soluzione off-the-shelf costa più della personalizzazione o non riesce a risolvere il vostro problema specifico. Qui non si tratta di ego tecnico: è una questione di ROI. Fine tuning, Retrieval Augmented Generation (RAG), e infrastrutture aperte come Reflection AI Beam (lanciato il 5 ottobre con 501 miliardi di parametri) hanno reso più accessibile costruire un sistema personale. Ma il costo non è zero e la manutenzione esiste.
In breve: una PMI valuta il modello su misura quando ha volumi di dati proprietari significativi, processi ripetitivi molto specifici, o quando gli abbonamenti pubblici non rispettano vincoli di privacy e latenza. Altrimenti conviene iniziare con ChatGPT API o Claude Opus 5.5, e aggiungere un livello di personalizzazione (RAG, prompt tuning) senza costruire da zero.
Abbonamenti vs. modello personalizzato: dove è il costo reale
Un abbonamento AI (ChatGPT Plus, Claude Pro, Google Workspace con Gemini) costa fra 20 e 40 euro al mese per utente, illimitato. Sembra conveniente, ma non regge se:
- Volumi enormi: oltre 100.000 richieste al mese, l'API di OpenAI o Anthropic cala i prezzi all'ingrosso, ma un modello fine-tuned su istanza propria diventa competitivo.
- Dati sensibili in cloud pubblico: un ospedale non manda cartelle cliniche a OpenAI. Una banca non manda documenti finanziari a Google. Esigenze di compliance europea sono il primo driver reale di un modello proprietario.
- Latenza: abbonamenti pubblici hanno rate limit e code di elaborazione. Un modello locale o su server dedicato risponde in millisecondi. Crittico per e-commerce, centralini, chatbot.
- Dipendenza da un fornitore: il mese prossimo ChatGPT aumenta il prezzo, smette di supportare una feature, o cambia i termini di servizio. Un modello vostro non cala licenze dall'alto.
Costruire da zero, però, chiede investimento iniziale: sviluppatori, data engineer, infrastructure. Non è una spesa una tantum.
Reflection AI Beam: cosa è e perché importa a ottobre 2024
Il 5 ottobre Reflection AI ha pubblicato Beam, un modello open da 501 miliardi di parametri. Non è un modello generico consumer: è stato progettato per far costruire alle aziende il proprio sistema, senza stare in coda a OpenAI o Google.
Beam entra in una categoria intermedia fra
- Modelli consumer (ChatGPT, Claude, Gemini): closed, pay-as-you-go, veloci, generici.
- Modelli open entry-level (Llama 70B, Qwen 32B): open source, personalizabili, ma più lenti e meno precisi.
- Modelli enterprise (fine-tune di GPT-4, Claude Opus): personalizzati, ma con partnership costosa e termini rigidi.
Beam si posiziona qui: open, robusto come Opus, e pensato per aziende che vogliono il controllo senza il costo di OpenAI Enterprise. Non è gratis (infrastruttura costa), ma il prezzo per token è prevedibile e scalabile.
Per una PMI: Beam importa se avete team tech interno e volete alleggervi da vendor lock-in di OpenAI. Se non avete data engineer, rimane complicato.
Fine tuning: addestrare l'AI sui vostri dati
Fine tuning significa aggiornare i pesi di un modello pre-addestrato con i vostri dati. Non è magia: serve un dataset pulito, etichettato, e almeno 100-500 esempi di input-output che rispecchiano il vostro caso.
Quando serve:
- Azienda B2B di consulenza: migliaia di contratti passati, risposte standard, FAQ. Fine-tune un modello su 300 esempi (domanda del cliente → risposta appropriata) e dimezza gli errori.
- Studio legale specializzato: sentenze della vostra pratica, opinioni sistematiche della vostra firma. Un fine-tune su Claude Opus o Llama alza la qualità delle risposte.
- E-commerce con catalogo proprietario: descrizioni di prodotto, taghe ricorrenti, regole di prezzo. Fine-tuning di GPT-3.5 su 1.000 esempi migliora recommendation e descrizioni.
Quando non serve:
- Startup di 10 persone con casella email caotica. Fine-tuning amplifica il rumore dei dati male organizzati.
- Processi che cambiano ogni mese. Fine-tuning è stabile su task ricorrenti; se la regola cambia, il modello diventa subito obsoleto.
Costo di OpenAI: training 0,008 dollari per 1K token di input, 0,024 per output. Un fine-tune modesto (500 esempi, 300 token medi) costa 100-150 dollari. Non enorme, ma va ripetuto se i vostri dati cambiano.
RAG: il modo intelligente di aggiungere contesto senza fine-tuning
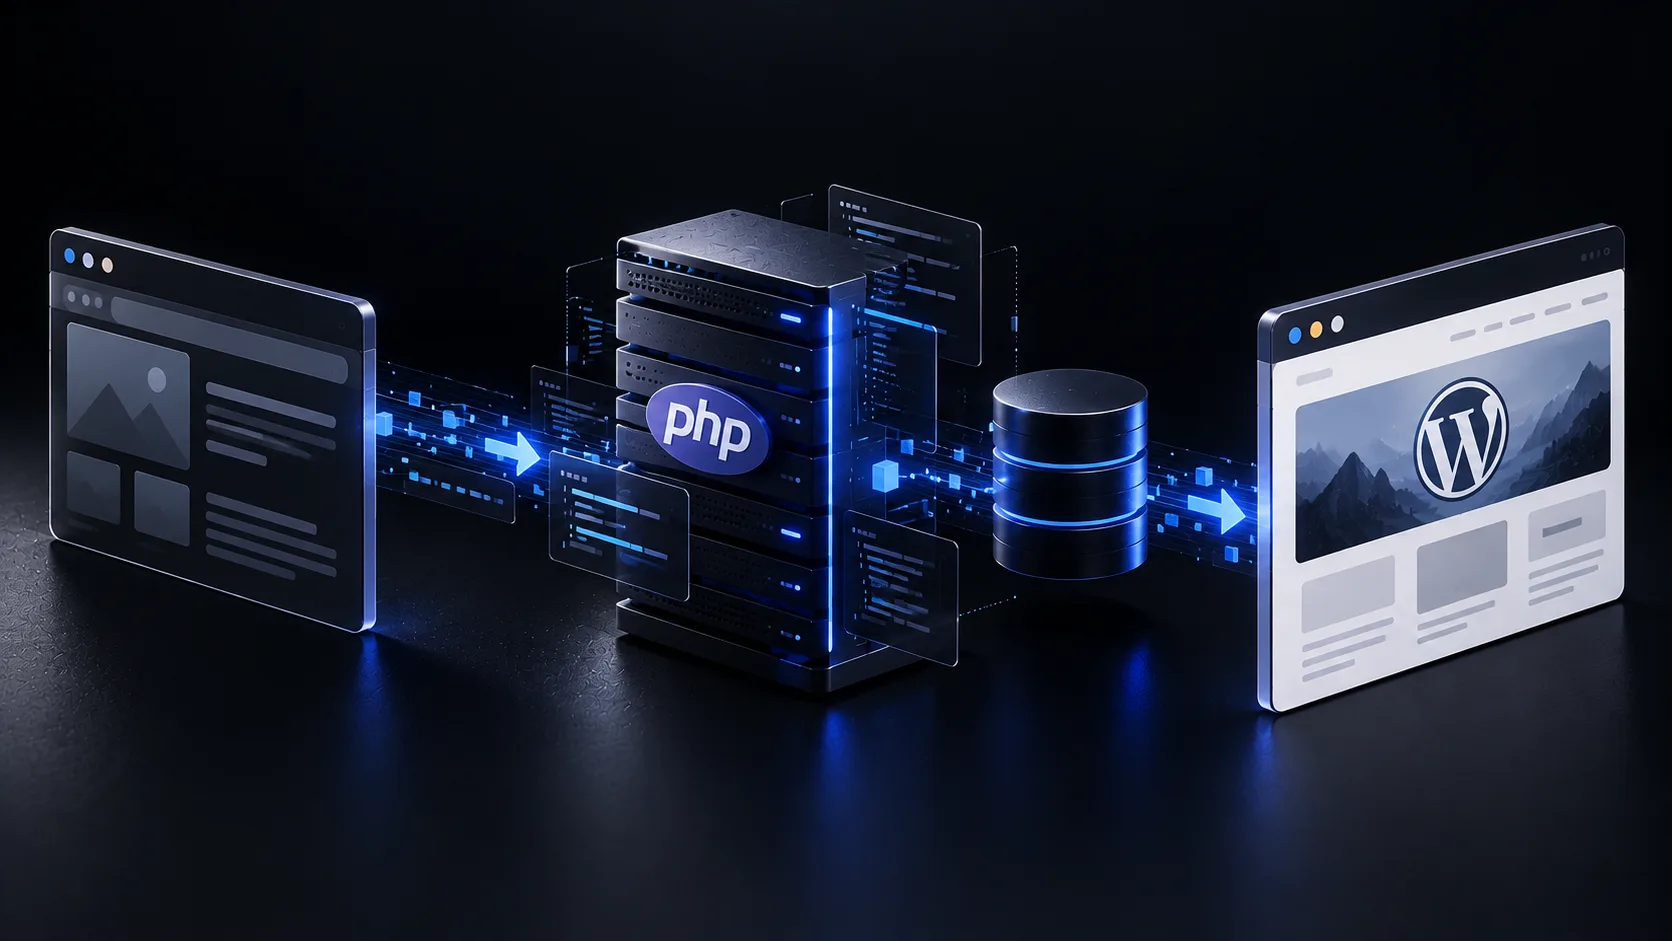
Retrieval Augmented Generation (RAG) non addestra il modello. Invece, recupera documenti rilevanti dal vostro archivio e li inserisce nel prompt prima di chiedere la risposta.
Scenario: gestionale con 50.000 clienti storici. Oggi, ChatGPT non sa niente di loro. Con RAG:
- Indicizzate i vostri dati (clienti, cronologia ordini, note di vendita) in un database vettoriale (Pinecone, Weaviate, PostgreSQL con pgvector).
- L'utente chiede: "Questo cliente è affidabile?"
- Il sistema recupera i 3-5 record più rilevanti del cliente.
- Il modello risponde basandosi su quei dati + la sua intelligenza.
Vantaggi:
- Nessun retraining: i vostri dati restano vostri, nel database, non dentro il modello.
- Aggiornamenti in tempo reale: il cliente paga una fattura, il database si aggiorna, la risposta dell'AI riflette subito il nuovo stato.
- Privacy nativa: i documenti non vanno a OpenAI se usate un modello locale + RAG interno.
Costo: database vettoriale (self-hosted, gratuito; oppure Pinecone, 25-100 dollari/mese) + API del modello (OpenAI, Claude, oppure Beam self-hosted). Sviluppo iniziale: 2-4 settimane per un team esperto.
Per una PMI, RAG è spesso il punto di equilibrio: intelligenza artificiale personalizzata senza la complessità del fine-tuning.
Reflection Beam vs. ChatGPT: quale sceglie una PMI
ChatGPT API (o Claude Opus 5.5 su API):
- Costo variabile: 2-5 centesimi per mille token medi.
- Nessuna infrastruttura: funziona in cloud altrui.
- Dipendenza dal fornitore: prezzo e feature cambiano su loro calendario.
- Best for: chatbot, automazioni, analisi testi, qualunque cosa non richieda dati proprietari massivi.
Reflection Beam (o Llama su istanza propria):
- Costo fisso: paghi il server, non per token. Di solito 50-200 dollari/mese per una GPU.
- Infrastruttura vostra: setup iniziale, manutenzione, aggiornamenti di sicurezza vostri.
- Libertà su fine-tuning e privacy: addestrare il modello sui vostri dati rimane interno.
- Best for: startup SaaS, aziende B2B con dati sensibili, processi mission-critical con milioni di richieste.
Una PMI con 20 dipendenti e un gestionale ordini tipicamente:
- Inizia con Claude Opus API + RAG interno (database proprietario, modello OpenAI in cloud).
- Migra a Beam o Llama self-hosted solo se i costi API superano 2.000 euro/mese oppure se la compliance lo vieta.
Costi reali e timeline: quanto spendete davvero
Scenario 1: Chatbot su misura per e-commerce
- Setup: prompt engineering + integrazione con gestionale + RAG su catalogo prodotti.
- Tempo: 1-2 settimane.
- Infrastruttura: OpenAI API, database vettoriale gratuito (Weaviate self-hosted), hosting del chatbot (100 euro/mese).
- Annuo: 1.500 euro infrastruttura + costi API (stimati 200-400 euro/mese per 50.000 richieste). Totale: 4.000-6.000 euro/anno.
Scenario 2: Modello fine-tuned per assistenza clienti
- Setup: raccolta 300 ticket passati, etichettatura, fine-tuning su Claude Opus, integrazione CRM.
- Tempo: 2-3 settimane (se i dati sono puliti).
- Training fine-tuning: 200 euro una tantum.
- Infrastruttura: Claude API, hosting (100 euro/mese).
- Annuo: 1.200 euro + 150 euro training + costi API (150-250 euro/mese). Totale: 2.900-3.600 euro/anno.
Scenario 3: Reflection Beam self-hosted
- Setup: noleggio GPU dedicata (Runpod, Lambda Labs, Crusoe), deployment Beam, fine-tuning interno.
- Tempo: 3-4 settimane (se avete un dev).
- Infrastruttura: GPU H100 su Runpod, 200-300 euro/mese. Fine-tuning interno (gratuito dopo il setup).
- Annuo: 2.500-3.600 euro + dev time (almeno 2 settimane di manutenzione/anno).
- Payoff: dalle 2.000 richieste/mese in su, costa meno di OpenAI API.
Scenario 4: Abbonamento ChatGPT Plus + prompt engineering
- Setup: nessuno. Usate il web o l'app.
- Tempo: zero, ma niente integrazione con sistemi.
- Costo: 20 euro/mese per utente.
- Annuo: 240 euro/utente. Per 5 utenti: 1.200 euro. Non scalabile oltre 5-10 utenti; niente API né automazioni serie.
Il punto: la scelta non è fra abbonamento e modello personalizzato. È fra:
- Abbonamento consumer (ChatGPT Plus) se usate solo persone, niente sistemi.
- API + RAG se automatizzate processi e avete dati proprietari.
- Fine-tuning se i vostri processi sono ripetitivi e i dati sono stabili.
- Self-hosted (Beam o Llama) se i volumi sono alti, la compliance lo richiede, o volete indipendenza totale.
Checklist operativa per decidere il modello giusto
- Quantificate le vostre richieste mensili: contate quante volte l'AI dovrà rispondere (ChatGPT con CRM? Chatbot? Generazione documenti?). Se under 10.000 richieste/mese, abbonamento o API consumer basta. Oltre 50.000, valutate self-hosted.
- Mappate i dati proprietari: avete un archivio di dati privati che l'AI deve conoscere (clienti, contratti, procedure, FAQ)? Usate RAG. Se no, il modello generico va bene.
- Verificate i vincoli di compliance: la legge vi obbliga a non inviare dati a fornitori cloud terzi (GDPR in UE, Legge 132/2025 per selezione personale, norme specifiche in sanità/finanza)? Se sì, self-hosted non è opzionale.
- Stimate il cost-per-request: dividete il budget annuale che potete spendere per il numero di richieste. Se costa più di 0,01 euro per request, cambiate architettura. Se costa meno di 0,001 euro, il modello self-hosted non conviene (usate API).
- Valutate la latenza: il vostro sistema può aspettare 2-3 secondi? (API cloud di solito). Oppure vi servono risposte in sub-500ms? (Self-hosted, oppure stream + caching). Scegliete di conseguenza.
- Calcolate il team: un modello personalizzato chiede almeno un dev part-time per il setup e la manutenzione. Una PMI senza team tech rischia di comprare complessità non gestibile. Valutate di outsourcing (agenzia, consulente freelance specializzato).
- Testate con MVP: non costruite il modello finale da subito. Partite con ChatGPT API + prompt semplice, misurate cosa funziona e cosa no. Solo allora aggiungete RAG o fine-tuning.
Gli errori da evitare
- Fine-tuning su dati sporchi: etichettatura frettolosa o dati incoerenti amplificano i problemi. Pulite prima di addestrare, non dopo.
- RAG senza governance del database: se il vostro database ha informazioni sbagliate, il modello "personalizzato" darà risposte sbagliate. Monitorare la qualità della fonte è prioritario.
- Scegliere self-hosted perché "più figo": infrastruttura e manutenzione costano in tempo e soldi. Se l'API pubblica risolve il problema, usatela.
- Ignorare il vendor lock-in di OpenAI: il prezzo sale, i termini cambiano, la compliance diventa un rischio. Pianificate un'exit strategy (RAG + modello open, oppure Anthropic come backup).
- Confondere personalizzazione con addestramento: RAG è personalizzazione light, fine-tuning è addestramento vero. La maggior parte delle PMI ha bisogno solo di RAG.
- Non misurare il risultato: costruite il modello, ma non verificate se ha davvero ridotto i costi o gli errori. Senza metrica, è solo consumo di budget.
Domande frequenti su modelli AI su misura per PMI
Reflection AI Beam è gratis?
No. Il modello è open source (potete scaricarlo), ma infrastruttura per farlo girare (GPU, server) costa 100-300 euro/mese. Reflection AI stessa offre API a pagamento. Alternativa: Llama 405B di Meta è pure open e gratis da scaricare, ma stessa storia su hosting.
Quando fine-tuning conviene davvero?
Quando avete 300+ esempi etichettati di task ripetitivi (Q&A, classificazione, estrazione testi), i dati sono stabili (non cambiano ogni settimana), e l'errore del modello generico è alto (over 30-40%). Per tutto il resto, RAG è più versatile.
RAG funziona con qualunque modello?
Sì, RAG è architettura, non legato a un modello specifico. Potete usarlo con ChatGPT, Claude, Gemini, o Llama. L'importante è che il modello supporti input lungo (contesto).
Se mi sposto da OpenAI a Beam, perdo gli investimenti?
No, se avete disaccoppiato bene l'API dal resto del sistema (API key centralizzata, wrapper interno, ecc.). Se avete hardcodato OpenAI dappertutto, migrare costa. Pianificate l'astrazione dall'inizio.
Llama, Qwen, Mistral: quale scelgo?
Dipende da task e lingua. Llama 405B (meta) è generico, affidabile, funziona bene su ragionamento e coding. Qwen di Alibaba è forte su cinese ma migliore di Llama su linguaggi non inglesi. Mistral è veloce e leggero (batte Llama su latenza). Per PMI italiana senza esigenze specialty: Llama o Qwen vanno bene.
Posso usare abbonamento ChatGPT + RAG con database mio?
Sì, è un setup ibrido valido: paginate ChatGPT API, ma il database rimane vostro, on-premise o su server vostro. RAG interno recupera i dati, l'API di OpenAI li elabora. Vantaggi di entrambi.
Il punto centrale
La domanda non è "modello su misura sì o no", ma "quale combinazione di modello, personalizzazione e infrastruttura minimizza il mio costo e i miei rischi?". Una PMI italiana che parte da zero oggi sceglie così: inizia con un abbonamento (ChatGPT Plus per gli uffici) o API (per automazioni), aggiunge RAG sul proprio database se ha dati sensibili, e migra a self-hosted solo se i volumi salgono sopra 100.000 richieste/mese oppure se la compliance lo impone. Fine-tuning rimane uno strumento specializzato per chi ha dati molto puliti e ripetitivi.
Reflection AI Beam importa non per la PMI media, ma per chi ha team tech interno e vuole davvero indipendenza da OpenAI. Per tutti gli altri, RAG + API resta il punto di equilibrio.
Iniziate dalla checklist operativa qui sopra: quantificate richieste, mapeate dati, verificate compliance. Il resto seguirà.